Четыре мини-ПК и четыре кабеля. Nvidia собрала настольный кластер из DGX Spark
На конференции SC26 Nvidia показала DGX Spark HPC Developer Kit. В комплекте четыре мини-ПК на GB10 Grace Blackwell, соединённых напрямую в кольцо. По данным Nvidia, на все четыре машины приходится 512 ГБ памяти и 20 ТБ на NVMe-накопителях. В числе примеров компания показала расчёты для материаловедения в LAMMPS. Для локального запуска нейросетей Nvidia заявляет поддержку моделей до 700 млрд параметров в формате NVFP4.
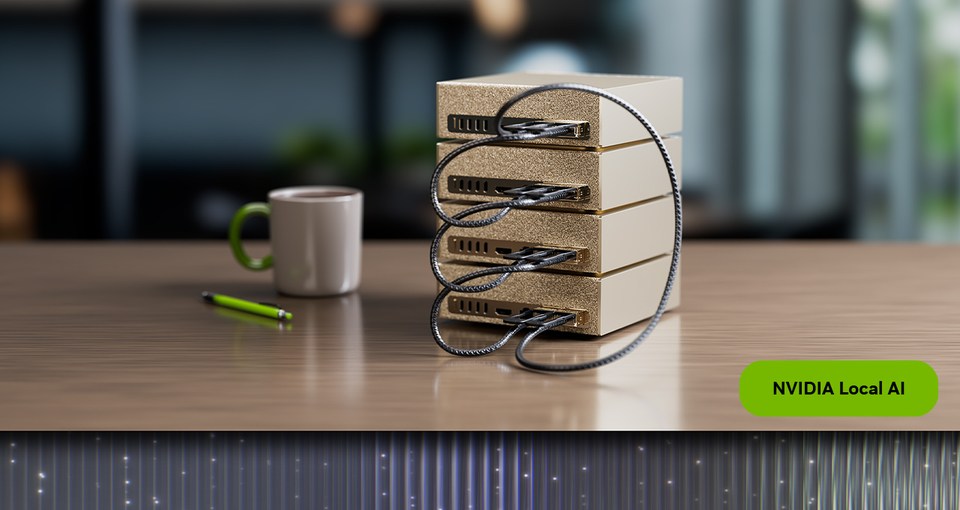
Четыре DGX Spark из анонса Nvidia. Длинный кабель соединяет крайние узлы и замыкает кольцо. Изображение Nvidia.
Как четыре Spark работают над одной задачей
Внутри одного Spark процессор и графика пользуются общими 128 ГБ памяти. У соседа свои 128 ГБ. Если большая модель не помещается в одну машину, движок вроде vLLM раскладывает её по нескольким узлам. По сети между ними ходят промежуточные результаты, а часть памяти на каждом узле нужна системе, рабочим буферам и кэшу контекста. Поэтому ориентироваться только на размер файла с весами модели нельзя.
- Разделить слои. Первый Spark считает свои слои и передаёт результат следующему, тот делает то же самое. Это конвейерный параллелизм. При одном запросе часть узлов может ждать своей очереди.
- Разделить вычисления внутри слоя. Узлы считают разные части одного слоя одновременно и регулярно обмениваются результатами. Это тензорный параллелизм. У Nvidia есть пример на vLLM, где Ray запускает рабочие процессы на узлах, а NCCL помогает им обмениваться данными.
- Раздать запросы. Если модель целиком помещается на одном Spark, можно держать копию на каждой машине. Тогда кластер обслуживает больше запросов одновременно, а один ответ по-прежнему считает один узел.
Как нарастить кластер
- Два Spark. Один прямой кабель между портами QSFP. Две машины по 128 ГБ дают 256 ГБ суммарно.
- Три или четыре. Каждый Spark соединяется с двумя соседями. В комплекте с SC26 схема такая: 1 ↔ 2 ↔ 3 ↔ 4 ↔ 1. Коммутатор не нужен. Для кольца из четырёх узлов Nvidia описывает ручную настройку.
- Пять и больше. Nvidia описывает схему с коммутатором и отдельным Ethernet-линком на 200 Гбит/с для каждого Spark. Помощник NVIDIA Sync поддерживает до четырёх узлов через коммутатор. Дальше сеть настраивают вручную или автоматизируют сами. Восемь машин по 128 ГБ дадут 1024 ГБ суммарно, если приложение умеет распределить конкретную модель на восемь узлов.
У одного порта ConnectX-7 потолок 200 Гбит/с, то есть 25 ГБ/с до накладных расходов. У локальной памяти Spark заявлено 273 ГБ/с. Если узлы постоянно ждут данные друг от друга, новый узел может дать место под модель, но не ускорить ответ. Поэтому для большой модели полезно замерять время ответа и скорость генерации, а для нескольких копий - сколько запросов они выдерживают одновременно.