Не Spark-ом едины. Microsoft запустила локальную ИИ-модель на кластере из трёх мини-ПК с AMD
Microsoft показала, как запустить одну большую нейросеть на нескольких Windows-ПК, соединённых по USB4. В демонстрации три мини-ПК на Ryzen AI Max+ 395 получили по 128 ГБ общей для процессора и графики памяти. На всех троих запустили Qwen3-235B-A22B, и модель выдавала около 18,5 токена в секунду. Из железа для связи хватило трёх кабелей USB4 на 40 Гбит/с.
Зачем три кабеля на три компьютера?
Каждый ПК хранит и обсчитывает свою часть модели. Чтобы выдать следующий токен, машины несколько раз обмениваются промежуточными результатами. Тут важна задержка: пока один компьютер ждёт данные от другого, свою часть работы он закончить не может. RDMA позволяет передавать данные между подготовленными участками памяти с меньшим числом копирований. В тесте Microsoft маленькие сообщения ходили туда и обратно примерно за 28-50 мкс. Это примерно вчетверо быстрее, чем передача тех же сообщений по UDP через тот же USB4.
| RDMA | 28 мкс | |
| UDP | 128 мкс |
| RDMA | 31 мкс | |
| UDP | 116 мкс |
| RDMA | 33 мкс | |
| UDP | 140 мкс |
| RDMA | 50 мкс | |
| UDP | 194 мкс |
Источник - замеры Microsoft.
Для этой схемы каждый ПК соединяют напрямую с каждым. У трёх машин получается треугольник из трёх кабелей, по два порта на корпус. У четырёх уже шесть кабелей и по три порта на корпус. Если пойти дальше, свободные разъёмы можно исчерпать быстрее, чем память. Поддержка пока заявлена для будущей экспериментальной сборки Windows Insider, а сама демонстрация работает на версии llama.cpp, которую Microsoft доработала для распределённых вычислений.
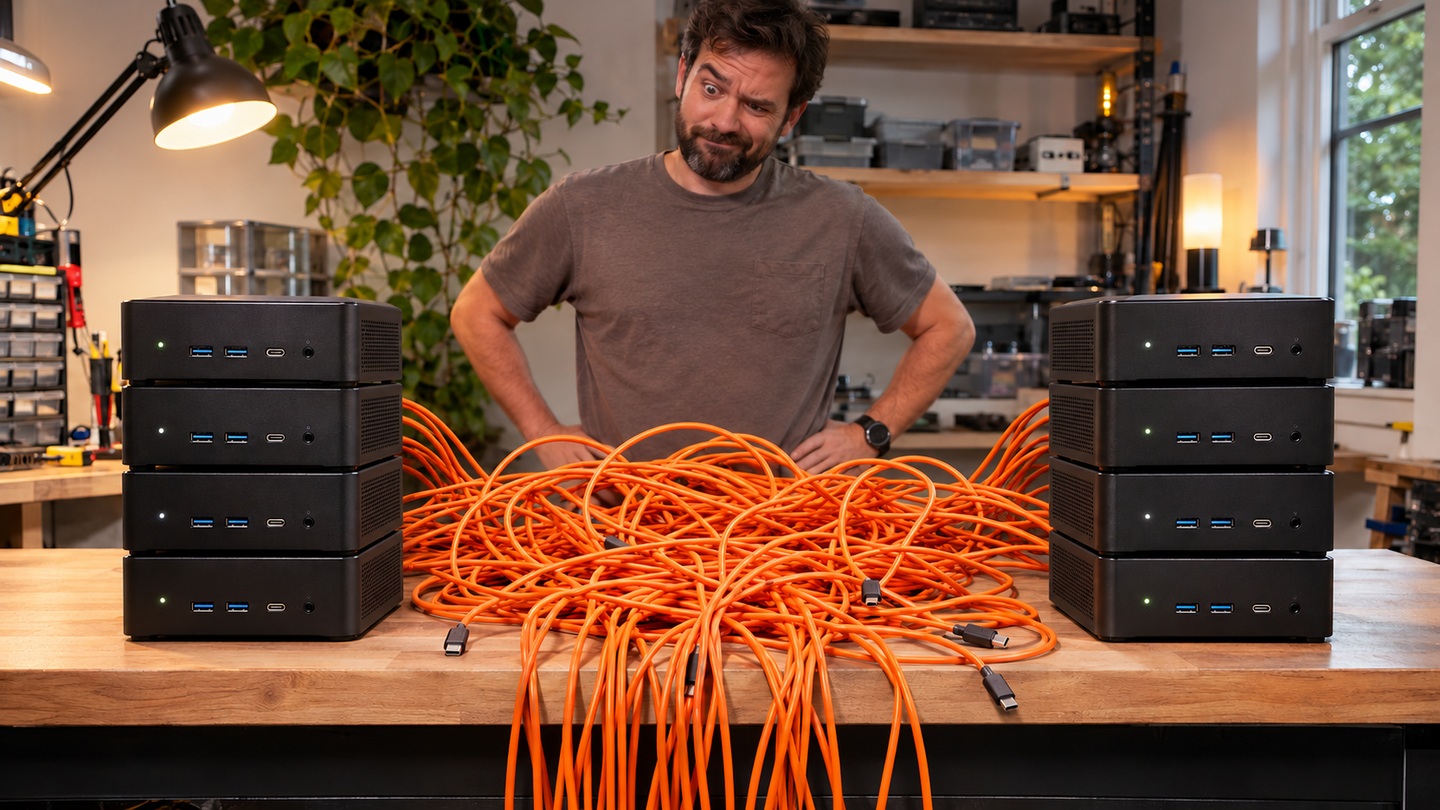
Если соединить восемь ПК каждый с каждым, уйдёт 28 кабелей USB4 и по семь портов на машину. И это ещё без питания. Иллюстрация сгенерирована через ИИ
Что получилось на Ryzen
Microsoft сообщила примерно о 18,5 токена/с генерации на трёх Ryzen на модели с 4-битной квантизацией. AMD же отдельно получила на трёх таких же по характеристикам узлах ~22 токена/с при генерации и ~118 токена/с при обработке запроса. Второй замер сделали на Q4_K_M модели при контексте в 1600 токенов и генерации 2048 токенов. Скорость обработки запроса показывает, как быстро модель читает входной текст. Скорость генерации - как быстро печатает ответ.
А что у DGX Spark?
Три DGX Spark по 128 ГБ. Это те же 384 ГБ суммарной памяти, что и у тройки Ryzen. Эндрю Майерс на трёх Spark получил 258 токенов/с на выходе в Qwen3-235B с TensorRT-LLM. Он распределил слои модели по узлам и замерял суммарную пропускную способность под нагрузкой. Число 258 показывает, сколько текста машины выдавали в сумме по запросам. Сравнивать его напрямую с 18,5 токена/с одного ответа у Microsoft смысла нет.
Два DGX Spark по 128 ГБ. Ближе к замеру AMD подошёл Tinker AI Lab. На той же Qwen3-235B-A22B в Q4_K_M два Spark выдали 18,2 токена/с генерации в llama.cpp. Но там был другой режим теста, а узлы обменивались данными через RPC по TCP. В отдельном исследовании на паре Spark с vLLM и NVFP4 задержка между токенами одного запроса составила 60 мс, то есть примерно 17 токенов/с при параллельном обсчёте слоёв. По этим цифрам видно, что у опубликованных конфигураций скорости одного ответа одного порядка. Для вывода, кто быстрее, нужен общий тест с одинаковыми весами, контекстом и нагрузкой.
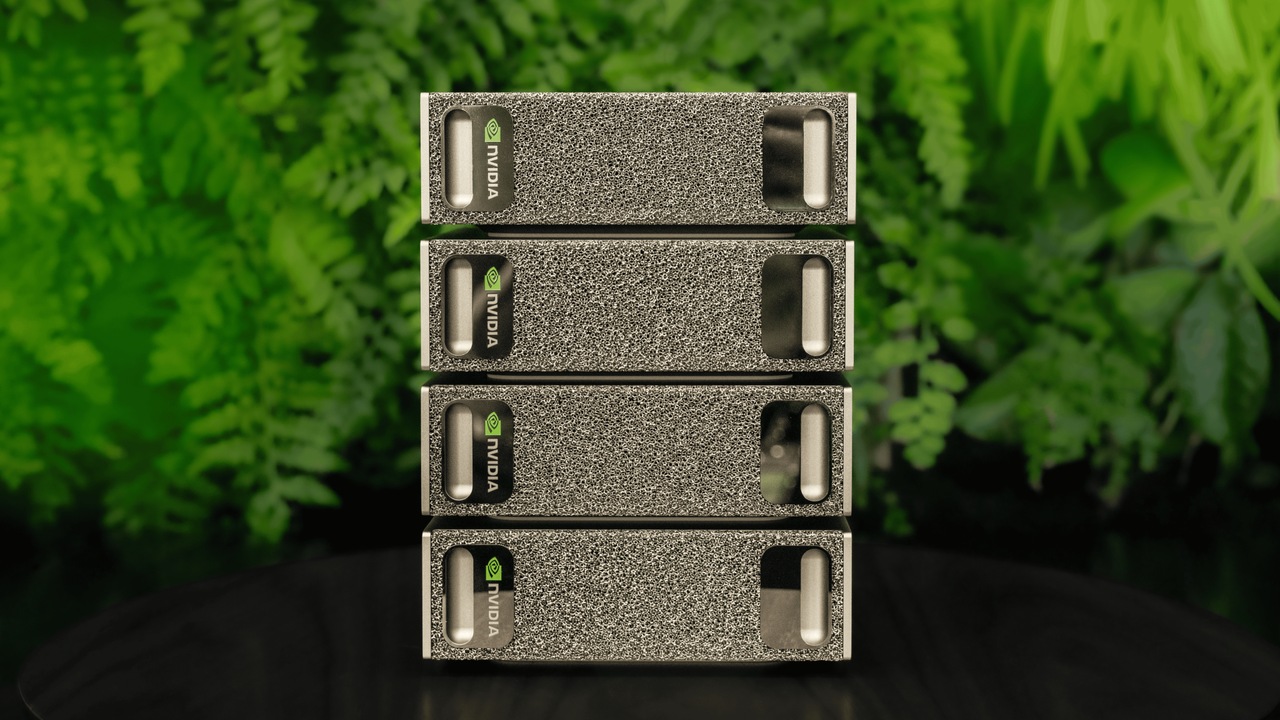
Четыре DGX Spark на снимке NVIDIA. В сравнении выше приведены замеры двух и трёх узлов.
По части проводов DGX Spark практичнее в плане подключения кластера из 4 и более рабочих станций. Три Spark в кольце требуют тех же трёх кабелей, что и три ПК в схеме Microsoft. А четыре Spark можно соединить четырьмя кабелями QSFP вместо шести USB4. У каждого тогда по два соседа, а связь идёт через встроенные ConnectX-7 с линками до 200 Гбит/с.
Для более крупных сборок NVIDIA описывает подключение через отдельный коммутатор с портами на 200 Гбит/с и подходящими кабелями QSFP. От каждого Spark к коммутатору идёт один кабель. NVIDIA Sync сам настраивает до четырёх узлов через коммутатор, а для большего кластера сеть придётся настроить вручную или своей автоматизацией. У варианта Microsoft свой плюс: если подходящие ПК с USB4 уже есть, то для показанной схемы хватит совместимых кабелей.